Einführung
KI-Sprechertrennung mit Seply trennt gemischte Stimmen.
Was ist Seply Speaker Separation?
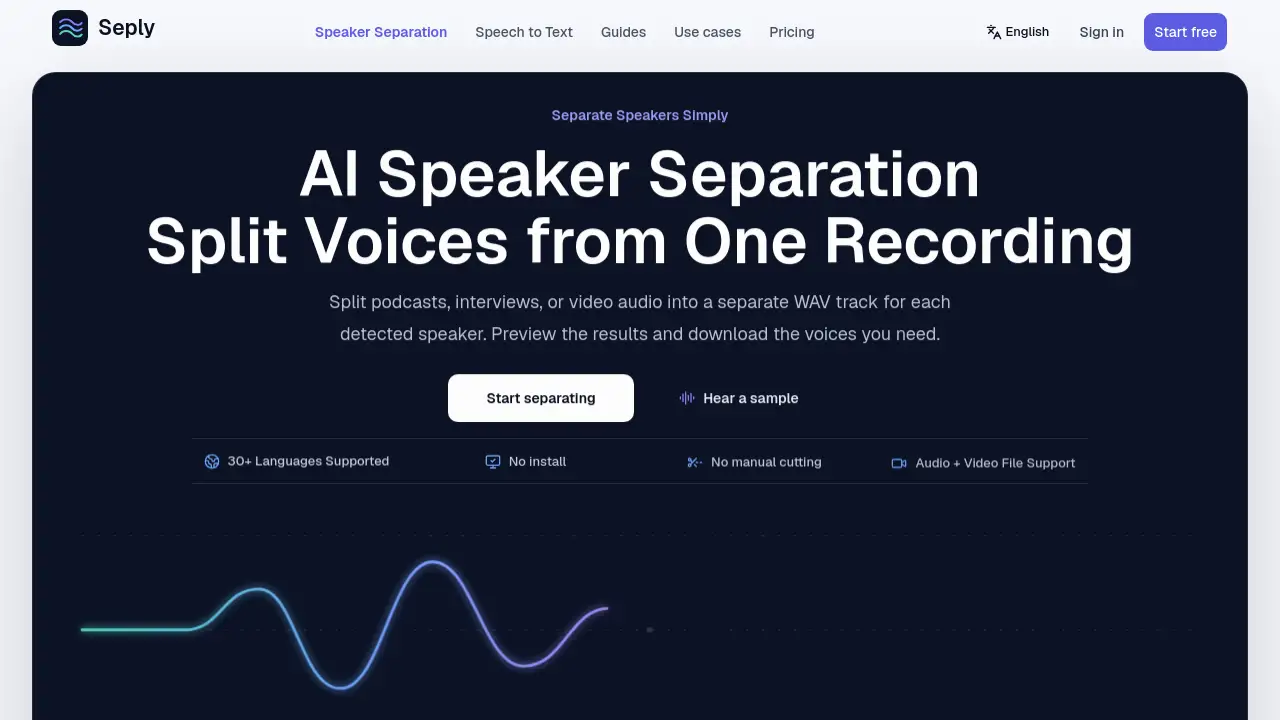
Seply Speaker Separation ist ein webbasiertes Tool, das KI-Sprechertrennung verwendet, um Podcasts, Interviews, Meetings oder Video-Audio in einzelne, zeitlich ausgerichtete Spuren für jeden erkannten Sprecher aufzuteilen. Anstatt eine gemischte Aufnahme manuell zu schneiden, laden Benutzer eine Datei hoch und lassen das System für KI-Sprechertrennung separate WAV-Dateien erstellen. Das löst ein häufiges Bearbeitungsproblem: Wenn mehrere Stimmen dieselbe Spur teilen, wirkt sich die Anpassung des Audios einer Person auf alle aus. Seply Speaker Separation gibt jeder Stimme ihre eigene Spur, sodass Editoren eine Sprecherspur stummschalten, den Pegel anpassen oder bearbeiten können, ohne die anderen zu berühren. Es unterstützt über 30 Sprachen und funktioniert mit Audio- und Videodateien. Das Tool für KI-Sprechertrennung ist für Sprache konzipiert, nicht für die Trennung von Instrumenten in Musik. Es ist nützlich für Podcaster, Journalisten, Videoeditoren, Meeting-Organisatoren und alle, die klare einzelne Stimmen aus einem Gespräch benötigen. KI-Sprechertrennung bedeutet hier mehr als nur zu kennzeichnen, wer wann gesprochen hat; sie erzeugt bearbeitbare Audiospuren.
Hauptfunktionen von Seply Speaker Separation
Individuelle Sprecherspuren
KI-Sprechertrennung erstellt eine unabhängige Audiospur für jeden erkannten Sprecher. Benutzer können nur die Stimmen herunterladen, die sie benötigen.
Zeitlich ausgerichtete Ausgabe
Jede getrennte Spur beginnt am selben Punkt und bleibt mit der Originalaufnahme ausgerichtet. So bleiben die Ergebnisse der KI-Sprechertrennung mit dem Schnitt synchron.
Automatische Sprechererkennung
Das System kann Sprecher automatisch erkennen oder Benutzer die erwartete Anzahl eingeben lassen. Das reduziert die manuelle Einrichtung für die KI-Sprechertrennung.
Unterstützung für Audio- und Videodateien
Laden Sie WAV, MP3, M4A, AAC, FLAC, MP4, MOV und andere Formate hoch. Videodateien liefern ihre originale Audiospur ohne Neukodierung.
Vorschau vor dem Download
Hören Sie den Originalmix und jede isolierte Sprecherspur an, ohne die Wiedergabeposition zu verlieren. Hören Sie sich dann die Ergebnisse der KI-Sprechertrennung in der Vorschau an und laden Sie WAV-Dateien für die Bearbeitung herunter.
Erweiterter Überlappungsmodus
Bei Unterbrechungen und gleichzeitigem Sprechen hilft der erweiterte Überlappungsmodus, überlappende Stimmen zu trennen. Ergebnisse variieren je nach Rauschen, Echo und ähnlichen Stimmen.
Private Verarbeitung und 30 Tage Zugriff
Aufnahmen und fertige Spuren werden 30 Tage lang privat gespeichert. Das gibt Benutzern Zeit, die Ergebnisse herunterzuladen und zu prüfen.
Speech-to-Text mit Sprecherbezeichnungen
Ein separates Speech-to-Text-Tool fügt Sprecherbezeichnungen und Zeitstempel hinzu. Das ist nützlich, wenn anstelle separater WAV-Spuren ein Transkript benötigt wird.
Anwendungsfälle für Seply Speaker Separation
Podcast-Produktion
Hosts und Gäste können jeweils eine bearbeitbare Spur erhalten. KI-Sprechertrennung erleichtert das Ausbalancieren von Pegeln und das Entfernen von Übersprechen.
Interview-Bearbeitung
Trennen Sie die Stimmen von Interviewer und Gast für sauberere Schnitte. Das hilft, wenn eine Person leise spricht oder unterbricht. KI-Sprechertrennung hält jede Stimme unabhängig.
Meeting-Aufnahmen
Teilen Sie Meeting-Audio nach Sprecher für Notizen, Zusammenfassungen oder Follow-up-Clips auf. Teilnehmer können einzeln geprüft werden.
Podiumsdiskussionen
Mehrere Sprecher in einem Raum können zu separaten Spuren werden. Editoren können wählen, welche Stimme hervorgehoben wird. KI-Sprechertrennung verarbeitet Aufnahmen mit mehreren Sprechern.
Video-Postproduktion
Laden Sie eine Videodatei hoch und erhalten Sie separate WAV-Audiospuren. Stellen Sie das originale gemischte Audio stumm und ersetzen Sie es durch die benötigten Sprecherspuren.
Content-Wiederverwendung
Verwenden Sie isolierte Stimmen, um Clips, Zitate oder Social-Media-Snippets zu erstellen. KI-Sprechertrennung spart manuelle Schnittzeit.
So verwenden Sie Seply Speaker Separation
- Melden Sie sich an und laden Sie eine Aufnahme hoch. Das Tool akzeptiert Audio- und Videodateien bis 1 GB.
- Wählen Sie die automatische Sprechererkennung oder geben Sie die erwartete Anzahl an Sprechern ein.
- Lassen Sie die KI-Sprechertrennung die Datei verarbeiten. Der Standardmodus verarbeitet typische Sprecherwechsel; der erweiterte Überlappungsmodus verarbeitet gleichzeitiges Sprechen.
- Hören Sie den Originalmix und jede getrennte Spur in der Vorschau an. Prüfen Sie Ausrichtung und Audioqualität.
- Laden Sie die WAV-Dateien herunter, die für den Bearbeitungsworkflow benötigt werden.
Zielgruppe für Seply Speaker Separation
- Podcast-Produzenten und Hosts
- Journalisten und Interview-Editoren
- Videoeditoren und Content-Creator
- Meeting-Organisatoren und Protokollanten
- Forscher und Transkriptionsnutzer
- Teams, die Aufnahmen mit mehreren Sprechern bearbeiten
Ist Seply Speaker Separation kostenlos?
Seply Speaker Separation bietet eine kostenlose Testversion mit 30 einmaligen Credits, 30 Tage gültig und ohne Kreditkarte. Kostenpflichtige Pläne verwenden Credits für KI-Sprechertrennung und Transkription.
| Plan | Preis | Funktionen |
|---|---|---|
| Kostenlose Testversion | $0 | 30 Credits einmalig; ca. 3 Minuten Sprechertrennung; 90 Minuten Transkription; erweiterter Überlappungsmodus |
| Starter | $12/Monat | 200 Credits monatlich; ca. 20 Minuten Sprechertrennung; 600 Minuten Transkription |
| Creator | $29/Monat | 600 Credits monatlich; ca. 60 Minuten Sprechertrennung; 1.800 Minuten Transkription |
| Studio | $65/Monat | 1.500 Credits monatlich; ca. 150 Minuten Sprechertrennung; 4.500 Minuten Transkription |
Die Standardtrennung verwendet 10 Credits pro angefangene Minute mit einem Minimum von 10 Credits. Der erweiterte Überlappungsmodus verwendet 60 Credits pro angefangene Minute mit einem Minimum von 60 Credits. Speech-to-Text verwendet 1 Credit pro angefangene 3 Minuten. Die Preise sind in USD. Monats- und Jahrespläne verlängern sich automatisch, bis sie gekündigt werden.
Vor- und Nachteile von Seply Speaker Separation
| Aspekt | Vorteile | Nachteile |
|---|---|---|
| Preisgestaltung | Kostenlose Testversion verfügbar; auf Credits basierende Preisgestaltung zeigt Schätzungen vor der Verarbeitung | Erweiterter Überlappungsmodus kostet mehr Credits |
| Funktionen | KI-Sprechertrennung, zeitlich ausgerichtete Spuren, automatische Erkennung, Video-Unterstützung | Für Sprache konzipiert, nicht für Musik-Trennung |
| Ausgabe | Individuelle WAV-Dateien, bereit für Editoren | Ergebnisse können je nach Rauschen, Echo und starker Überlappung variieren |
| Zugriff | Keine Installation erforderlich; browserbasiert | Uploads auf 1 GB begrenzt; Ergebnisse 30 Tage verfügbar |
| Datenschutz | Private Verarbeitung und geschützter Zugriff | Erfordert Upload-Rechte für die Aufnahme |
Häufig gestellte Fragen zu Seply Speaker Separation
Kann KI-Sprechertrennung zwei Stimmen in einer Aufnahme trennen?
Ja. Seply teilt gesprochene Gespräche in eine separate, zeitlich ausgerichtete WAV-Spur für jeden erkannten Sprecher auf. Benutzer können jede Stimme in der Vorschau anhören und die benötigten Spuren herunterladen. Es ist für Sprache konzipiert, nicht dafür, Sänger von einem Song zu trennen.
Kann ich zwei Personen trennen, die gleichzeitig sprechen?
Der erweiterte Überlappungsmodus ist für Unterbrechungen und gleichzeitiges Sprechen konzipiert. Er erfordert einen erfolgreichen Kauf. Ergebnisse variieren je nach Rauschen, Echo, ähnlichen Stimmen und dem Ausmaß der Überlappung. Ein Teil der anderen Stimme kann in einer Spur verbleiben.
Kann ich nur die Stimme einer Person behalten?
Ja. Nach der KI-Sprechertrennung können Benutzer die resultierenden Spuren anhören und nur die WAV-Datei für die gewünschte Person herunterladen. Das Tool fragt vor der Trennung nicht nach einem Namen oder einer Stimmprobe. Die Spur behält das originale Timing bei, daher können Pausen erhalten bleiben.
Welche Dateien kann ich für die KI-Sprechertrennung hochladen?
Standard unterstützt WAV, MP3, M4A, AAC, FLAC, OGG, OPUS, WMA, Speex, MP4, AVI, MOV, MKV und WebM. Der erweiterte Überlappungsmodus akzeptiert WAV-, FLAC-, MP3-, AAC-, M4A-, MP4- und MOV-Dateien bis zu 90 Minuten. MP4- und MOV-Dateien müssen AAC- oder PCM-Audio enthalten.
Wie funktionieren Credits für Seply Speaker Separation?
Der Server berechnet die Mediendauer und rundet auf die nächste ganze Sekunde. Die Standardtrennung verwendet 10 Credits pro angefangene Minute mit einem Minimum von 10 Credits. Der erweiterte Überlappungsmodus verwendet 60 Credits pro angefangene Minute mit einem Minimum von 60 Credits. Die genaue Schätzung erscheint vor der Verarbeitung.
Ist Sprechertrennung dasselbe wie Sprecherdiarisierung?
Nein. Sprecherdiarisierung kennzeichnet, wer wann gesprochen hat. KI-Sprechertrennung erstellt eine individuelle Audiospur für jeden erkannten Sprecher. Seply bietet außerdem ein separates Speech-to-Text-Tool, wenn ein Transkript mit Sprecherbezeichnungen benötigt wird.
Tags zu Seply Speaker Separation
KI-Sprechertrennung, Seply Speaker Separation, Podcast-Audio nach Sprecher aufteilen, Sprecher in Audio trennen, Sprechertrennungstool, Podcast-Sprechertrennung, Interview-Sprechertrennung, Stimmen aus Aufnahme trennen, zeitlich ausgerichtete WAV-Spuren, Sprecherdiarisierung vs. Trennung, KI-Stimmtrennung, Online-Audio-Splitter