はじめに
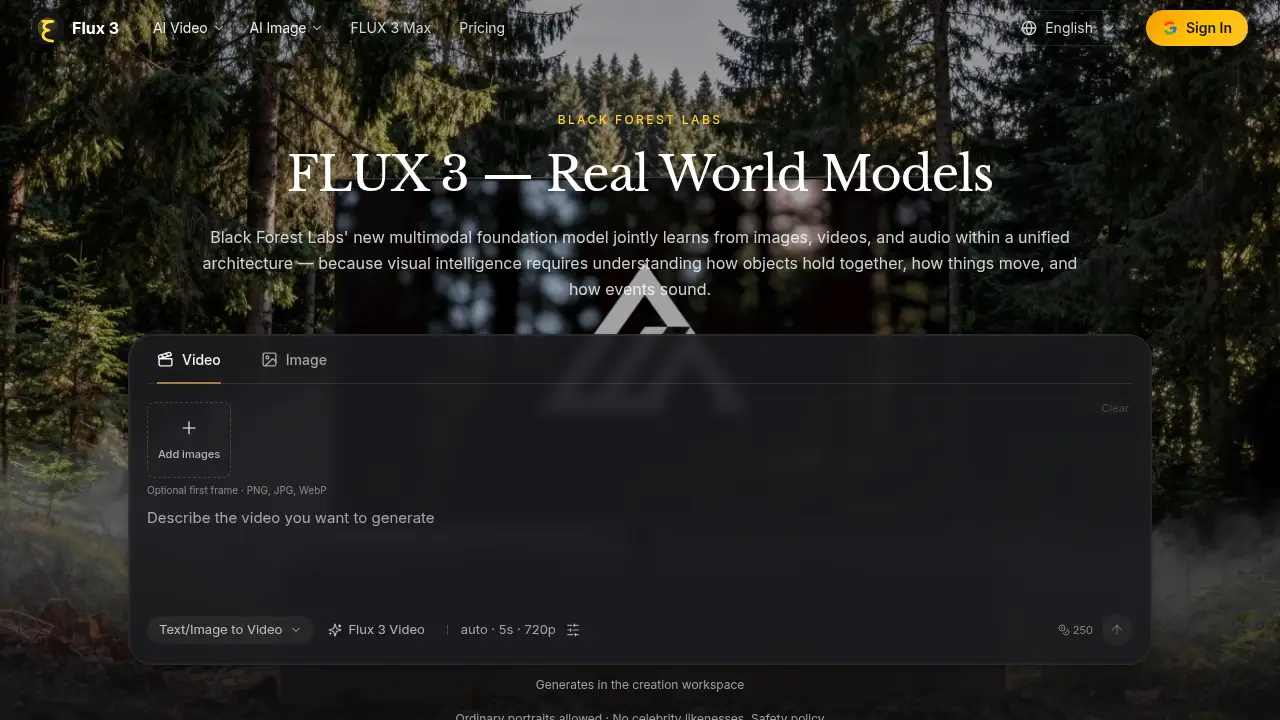
Flux 3は、Black Forest Labsによるマルチモーダル基盤モデルで、画像、動画、音声を1つの統合アーキテクチャ内で学習します。一度に1種類のメディアを変換するのではなく、Flux 3は物体がどのようにまとまり、物事がどのように動き、出来事がどのように聞こえるかを理解することを目指しています。これにより、動画生成、画像編集、ネイティブ音声を1つのクリエイティブシステムに統合します。
Flux 3とは?
Flux 3は、Black Forest Labsの新しいマルチモーダル基盤モデルで、同社がSelf-Flowと呼ぶ技術に基づいて構築されています。この技術は、マルチモーダル生成と理解を同じアーキテクチャ内で整合させ、動画、画像、音声にわたって同時にスケールさせます。これが解決する中心的な課題は分断です。ほとんどのクリエイティブツールは、動画、静止画、音声を別々のモデルが扱う別々の作業として扱います。Flux 3はそれらを理解すべき1つの世界として扱います。
これが重要なのは、視覚的知能が文脈に依存するからです。ガラスがどのように割れるかを知っているモデルは、それがどのように聞こえるべきか、破片がフレーム間でどのように動くべきかも知っています。Flux 3はアーリーアクセスを通じて段階的にリリースされ、最初に動画生成が利用可能になり、その後、追加機能が順次展開されます。
このモデルは、単一モダリティの変換ツールではなく、インテリジェントなクリエイティブパートナーを求めるクリエイター、マーケター、デザイナー、ロボティクスチーム向けに設計されています。要するに、Flux 3は現実世界を単にレンダリングするのではなく、モデル化しようとするマルチモーダルAIシステムです。
Flux 3の主な機能
ネイティブ音声付き動画生成
テキストから動画へのクリップを生成し、開始画像をアニメーション化し、動画間で参照を転送し、既存の映像を継続できます。すべて、最大約20秒の同期されたネイティブ音声付きです。キーフレームから動画への制御により、クリエイターは動きとペースをより細かく指示できます。
多言語ダイアログとサウンドデザイン
人間の表情を捉え、音を物理的出来事に結びつけ、1つのシーケンス内で多言語ダイアログを生成します。Flux 3はこれらの能力を組み合わせ、数秒の途切れた断片ではなく、数分続くフローを作れます。
エージェント型マルチショットチェーン
個々のクリップを、視覚参照付きのより長いマルチショットシーケンスに連結し、キャラクターがシーン間で一貫して見えるようにします。これにより、Flux 3の動画生成は、単発のプロンプトからクリップへのツールよりも物語制作に役立ちます。
画像合成と編集
幅広いスタイル、アスペクト比、解像度で画像を合成・編集します。複雑なプロンプトへの忠実度と、複数言語での高精度なテキストレンダリングにより、画像編集が実際のデザイン作業に実用的になります。
スタイルの多様性とタイポグラフィ
同じモデル内で、カムコーダーで撮影したような自然な映像、アニメーション、映画的なルックの間を移動できます。Flux 3はタイポグラフィやアニメーションデザインも扱います。これは生成動画ツールがしばしば苦手とする領域です。
行動予測
Flux 3にはネイティブの行動予測が含まれており、FLUX-mimicなどの特化したファインチューニング済みモデルは、事前学習済みの動画バックボーンをダイナミクスを認識する基盤として利用します。これは生成メディアとフィジカルAIの橋渡しです。
初期ベンチマーク性能
予備的な720pのテキストから動画への評価では、Flux 3は直接比較で複数の主要モデルより好まれました。アーリーアクセス中にさらなる改善が見込まれています。
Flux 3のユースケース
クリエイティブおよびソーシャル動画制作
ソーシャルチャンネル向けに、ネイティブ音声、タイポグラフィ、一貫したスタイリングを備えたショートフォームクリップを制作します。クリエイターは、別々の動画ツールと音声ツールを切り替えることなく、Flux 3の制作ワークスペースで素早く反復できます。
マーケティングと広告キャンペーン
キャラクターや製品がシーン間で視覚的に一貫したマルチショットプロモーションを構築します。マーケターは、本格的な制作予算を確定する前に、Flux 3マルチモーダルAIでコンセプトをテストできます。
デザインと画像編集
多くのアスペクト比で静止画を生成・洗練し、画像内に正確な多言語テキストを直接レンダリングします。デザイナーは、画像編集アプリと動画生成アプリを使い分けるのではなく、単一のワークフローを利用できます。
ロボティクスとフィジカルAI研究
行動予測とダイナミクスを認識する動画バックボーンを使用して、シミュレーションやコンピューター利用のシナリオを探索します。Flux 3は、動きの理解がそのレンダリングと同じくらい重要な身体性AIに取り組むチームを支援します。
ストーリーテリングとマルチショットナラティブ
参照に導かれた一貫性で、クリップをより長いシーケンスに連結します。Flux 3は、ストーリーテラーがランダムに生成されたのではなく、つながっていると感じられるシーンを組み立てるのを支援します。
Flux 3の使い方
- Flux 3のウェブサイトにアクセスし、アーリーアクセスを通じて制作ワークスペースを開きます。
- モードを選択します — テキストから動画、画像から動画、または動画から動画への参照転送。
- 必要に応じて、最初のフレームをPNG、JPG、WebPファイルとしてアップロードし、冒頭ショットをガイドします。
- 被写体、動き、スタイル、および希望するダイアログや音を説明する明確なプロンプトを書きます。
- クリップを生成し、結果を確認してから、必要に応じてショットを連結または改善します。プロンプトとコンテンツは、プラットフォームの安全性および許容利用ポリシーの範囲内に保ってください。
Flux 3の対象ユーザー
- 動画クリエイターとソーシャルメディアのストーリーテラー
- マーケターとブランドキャンペーンチーム
- 画像とモーションの両方に携わるデザイナー
- シーンをプロトタイピングする映画制作者やアニメーター
- ロボティクスとフィジカルAIの研究チーム
- マルチモーダルAIシステムを探究する開発者
Flux 3は無料?
Flux 3は現在、アーリーアクセスを通じて段階的に展開されており、公開されている価格詳細は限られています。モデルの価格ページが、現在のプラン、クレジット、制限を確認するための最も信頼できる場所です。
| プラン | 価格 | 機能 |
|---|---|---|
| アーリーアクセス | 異なる | 動画生成を含む、段階的なFlux 3機能へのアクセス |
| 有料階層 | 公式価格ページを参照 | より多い生成量と拡張された機能アクセス |
生成には制作ワークスペース内でクレジットが消費されると思われるため、大規模なプロジェクトを計画する前に、ユーザーはflux3.dev/pricingの公式価格ページを確認する必要があります。
Flux 3の長所と短所
| 側面 | 長所 | 短所 |
|---|---|---|
| 機能 | 動画、画像、音声、行動予測を1つのモデルに統合 | 起動時にすべての機能が利用できるわけではない |
| 音声 | ネイティブの同期音声と多言語ダイアログ | クリップは1回の生成あたり約20秒に制限 |
| 一貫性 | 視覚参照付きのマルチショットチェーンによりキャラクターを安定して維持 | 長いナラティブには依然として手動でのチェーンが必要 |
| アクセス | 段階的なアーリーアクセスによりフィードバックと安全性テストを募る | 価格と制限が完全には公開されていない |
| スタイル範囲 | カムコーダー映像からシネマティックなルックまで幅広くカバー | ベンチマーク結果は予備的なもの |
Flux 3に関するよくある質問
Flux 3とは?
Flux 3は、Black Forest Labsによるマルチモーダル基盤モデルで、画像、動画、音声から共同で学習します。同じ基盤アーキテクチャから、動画生成、画像編集、行動予測を実現します。
Flux 3は動画だけでなく音声も生成しますか?
はい。Flux 3の動画生成には、同期されたネイティブ音声に加え、多言語ダイアログとシーン内の物理的出来事に結びついたサウンドデザインが含まれます。
Flux 3のクリップはどのくらいの長さですか?
個々の動画生成は最大約20秒で、マルチショットチェーンを使って一貫したキャラクターを持つより長いシーケンスを構築できます。
Flux 3は誰でも利用できますか?
Flux 3は、動画生成から始めて、アーリーアクセスを通じて段階的にリリースされています。フィードバックと安全性テストが続くにつれて、追加機能が期待されています。
Flux 3は画像編集に使用できますか?
はい。Flux 3は、スタイル、アスペクト比、解像度にわたる画像合成と編集をサポートし、プロンプトへの忠実度と多言語テキストレンダリングが向上しています。
Flux 3が単一モダリティツールと異なる点は何ですか?
Flux 3マルチモーダルAIは、各形式を個別に扱うのではなく、動画、画像、行動にわたって世界理解を共有するため、一貫性、動き、音声に役立ちます。
Flux 3タグ
Flux 3、Flux 3マルチモーダルモデル、Black Forest Labs、マルチモーダルAI、Flux 3動画生成、ネイティブ音声AI動画、テキストから動画へのモデル、AI画像編集、マルチショット動画チェーン、行動予測AI、FLUX-mimic、音声付き生成動画